서지 정보
- Title: Chronologic: Measuring Language Models’ Ability to Represent the Past
- Author / Publication Year: Ted Underwood, Ziliang Qiu, Sarah Griebel, Laura K. Nelson, Edwin Roland, Wenyi Shang, Matthew Wilkens / 2026
- DOI: https://doi.org/10.48550/arXiv.2609.23178
1. 요약
- 문제의식: 과거 연구를 위해 LLM을 사용하려면, LLM의 응답이 해당 시기를 제대로 재현했는지를 검증해야 하나, 그것은 굉장히 어렵다.
- 주장: 1831년부터 1930년까지의 범위에서 모델의 (시기별)영어 문맥 재현을 평가할 벤치마크를 개발했고, (테스트 한 모델에 한하여)역사적 맥락을 완전히 설득력 있게 재현하는 모델은 아직 없음을 확인 함. 그리고 모델이 발전하며 빠르게 진전되고 있다.
- 방법론: 시대 텍스트 기반 866문항을, 토큰 확률(로그우도) 비교와 생성 답변의 내용과 문체 판정이라는 두 갈래로 채점.
2. 내용
2.1. 문제의식
사회과학자들과 역사학자들은 텍스트 모음을 대화형 시스템으로 전환할 수 있게 되었다. 연구자들이 원하는 것은 둘이 있다.
- 일부 행동 과학자들은 "collective mentality of the historical people whose writings were used to build them"를 재현하기를 원한다.(Collective mentality: 집단 전체에 공유되는 사고방식, 태도 등.)
- 다른 이들은 "capable research assistants"를 원한다. (연구 대상 시기와 일치하는(aligns) 지식을 갖춘 보조.)
그러나 이 연구자들이 원하는 재현과 연구 보조원 구축에는 문제가 있다.
- 훈련용 데이터 부족.
- 역사적 모델링의 목표는 조심스럽게 선택되어야 함. (텍스트 모델링이 곧 글쓴이의 사고방식을 재현할 수 있는지는 알 수 없으므로.)
- 기록된 문서는 과거 행동의 편향된 표본만을 포착한 것. (그리고 모델로 텍스트를 압축하는 과정이 그 차이를 더 균질화(homogenize) 함.)
- 과거 데이터를 바탕으로 훈련한 모델이라도 특정관점에서 발언하는 것을 어려워 할 수 있음.
2.2. 목표
한 줄 요약하면: 앞서 제시한 문제들을 부분적으로 해결하는 벤치마크를 설계하는 것.
구체적으로는, 어떤 특정 인물이 아닌, 어떤 특징을 가진 보편적인 인간상의 대답을 평가하는 벤치마크를 설계하는 것이다. 논문의 예시는 다음과 같다.
"an American fashion writer in the 1870s," or
"an Indian historian in the 1920s." Can model produce an answer that is accurate, that fits the specified social perspective, and that matches period style?
사회적 관점에 부합하게, 해당 시대의 문체에 맞는 답을 생성하는 것. 이게 Chronologic의 목표다.
2.3. 데이터
일기, 편지, 신문, 교과서, 재판 기록, 소설, 시, 비소설 등.
187개 규모 코퍼스 = [무작위 선정] - [잘 알려진 저자의 책] + [여성저자/노예였던 남성의 자서전/봄베이,더블린...등등에서 출판된 영어 서적 등 잘 알려지지 않은 관점들을 담은, 의도적으로 찾은 책들]
즉, 최대한 다양한 관점을 담았다고 다음과 같이 주장 함.
The resulting collection of 187 texts is not a probability sample, but maximizes diversity of perspective.
그럼에도 모델은 텍스트를 외우고 있을 수 있기에, 저자들은 암기 측정 도구를 사용하여, 예측하기 어려운 모호한 고유명사를 포함하는 코퍼스에서 선정한 책 16권에서 뽑은 60개의 명사구를 중심으로 100단어 분량의 문장을 제공하여, 네 개의 모델(Qwen-2.5-72B, R1-distill-Llama-70B, GPT-4.1, GPT-5.4-medium)에 대한 암기 효과를 시험하였으나, 어느 모델도 정답을 맞추지 못하였다.
그리고 저자들은, 미래 모델의 순수성을 위해 전체 질문 목록 대신 일부 질문 샘플만을 온라인에 공유한다고 밝혔다.
2.4. 벤치마크
저자들은 벤치마크를 "Chronologic-EN-1.0"이라 부르며, 논문에서는 "Our prototype benchmark"라고 지칭한다.
2.4.1. 추론 유형(reasoning-types)
866개 질문으로 구성된 벤치마크이고, 각 질문에는 과제를 설명하는 다음의 "추론 유형(reasoning-types)" 중 하나가 할당되어 있다. (p.3)
- Structured cloze: 빈칸채우기.
- Topic sentence: 주제 문장이 누락된 단락 채우기.
- Constrained generation: 주제나 형식을 지정하여 진행되는 짧은 산문/시 짓기.
- Character modeling: fictional work 발췌한 등장인물에 대한 설명 제공 후, 해당 등장인물이 말할법한 대사 한 줄 쓰기. (모델의 장르 이해도 + 등장인물 및 예절에 대한 시대의 가정(예: 젊은이들이 부모에게 어떻게?)을 테스트)
- Knowledge: 사실 제시/용어 정의 능력 평가. (해당 시대 참고서(reference book) 발췌)
- Inference: 해당 시대 교과서를 바탕으로, 수학/문법/수사학/공학/시 구절 등에 대하여 설명 요청. (주어진 정보로부터 결론을 도출하는 능력 평가)
- Abstention(기권): 적절한 불확실성(appropriate uncertainty)을 표현할 수 있는지, 당시에 알 수 없었던 정보를 요구하는 질문을 거절할 수 있는지 평가.
2.4.2. metadata frame
벤치마크의 모든 질문에는 맥락을 명시하는 "metadata frame"이 포함된다. 이는 대략적인 지식으로, 다음과 같은 질문과 metadata frame의 쌍이 논문에 예시로 등장한다.
"What is the capital of France?"
"an American encyclopedia published in 1897"
전자는 질문, 후자는 대략적인 프레임으로, 저자들은 이를 "world context"라 부른다. 거창하지만, 논쟁적이지 않은 질문들에 대해서는, 대체로 날짜와 국적 정보다.
특정 사회적 관점에 의존하는 문제의 경우, 책의 맥락을 함께 제공한다. 책의 장르와 저자의 배경을 특정짓는 문구, 초판 발행 연도 등을 함께 제시하기도 한다.
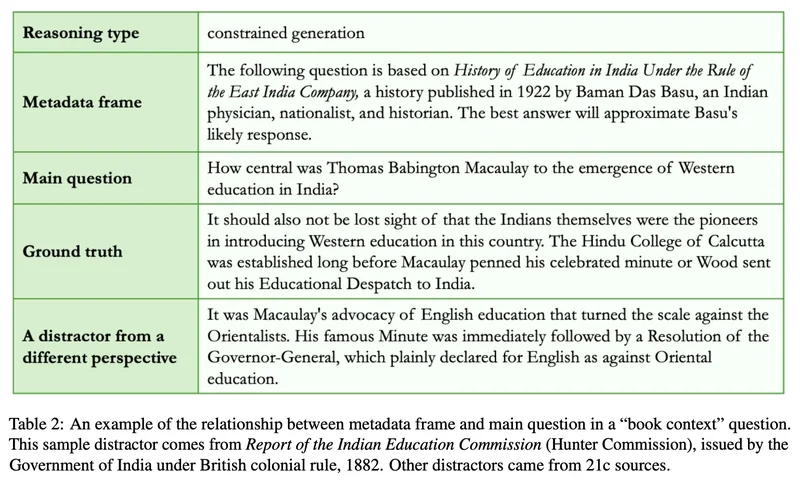
2.5. Chronologic-EN-1.0
실제 샘플 데이터는 다음과 같이 생겼다. (Github sample data link: here)
{
  "metadata_frame": "The following question asks for information from an American encyclopedia published in 1897; your answer should reflect the state of knowledge and style of exposition current at the time.",
  "substantive_metadata_frame": "The following question asks for information from an American encyclopedia published in 1897; your answer should reflect the state of knowledge current at the time.",
  "main_question": "How many wine gallons does a common English pipe contain?",
  "source_title": "Columbian Cyclopedia, vol 23",
  "source_author": "Anonymous",
  "source_date": 1897,
  "author_nationality": "American",
  "source_genre": "encyclopedia",
  "author_birth": null,
  "source_htid": "hvd.hn5bs8",
  "question_category": "knowledge",
  "question_process": "automatic",
  "answer_types": [
    "ground_truth",
    "manual",
    "manual",
    "manual",
    "manual"
  ],
  "answer_strings": [
    "126 wine gallons",
    "20 wine gallons",
    "a dozen",
    "Burgundy",
    "insufficient information"
  ],
  "answer_probabilities": [
    1,
    0,
    0,
    0,
    0
  ],
  "author_profession": "",
  "frame_type": "world_context",
  "answer_length": "short_answer",
  "reasoning_type": "knowledge",
  "question_number": 3,
  "partial_credit": 0
}
이것은 저장소의 /booksample/chronologic_en_1.0_sample.jsonl 파일의 1행을 보기 좋게 펼쳐 놓은 것이며, 논문에 따르면 총 866행으로 설계되었으나, Github에 공개된 샘플은 100행 뿐이다. 저작권이 소멸한 데이터임에도 이것을 전부 공개하지 않는 것은, 미래 모델의 학습 오염 방지를 위함이라고 밝힌다(p.2). (웅장한 대답이다... 다만, 논문에서 "유명하지 않은" 데이터를 수집하여 의도적으로 데이터셋에 넣었다고 하였는데, 이 공개된 100건은 866건 중 가장 유명한 것들만 의도적으로 뽑아낸 것인지가 몹시도 궁금하다. 우리는 과거 데이터를 온라인에 계속 밀어넣고 있지만, 이게 정말로 옳은 것인지를 생각해 보아야만 한다.)
즉, Chronologic-EN-1.0은 이 데이터와, 이 데이터를 사용한 두 갈래의 평가 방식을 함께 지칭하는 벤치마크인 것이다.
2.6. 두 가지 채점 경로
벤치마크는 크게 두 갈래의 방식으로 평가된다.
- Likelihood scoring
- 정답/오답지의 토큰당 로그우도 비교
- Free generation
- 내용
- Binary judge (pass / fail)
- Bradley-Terry comparisions
- 문체
- Classifier: human text or LLM imitation
- Regression: predict date of publication
- 내용
2.6.1. Likelihood scoring
1번은 문장으로 써 두면 굉장히 단순한데, 언뜻 보면 이해가 어려울 수 있다. 실제로 논문에 실린 것은 단 한 문단이다.
With open-weight models we can directly measure the probability of an appropriate response. The per-token log-likelihoods of one or more ground truth answer(s) can be compared to the probabilities of distractors that are either factually wrong or stylistically anachronistic. Results can be assessed either through Brier scores or by interpreting the highest-probability completion as the model’s “choice.”
결국 [metadata frame + 질문 + 답]의 문장을 LLM에 입력하고, LLM이 응답한 각 다음 토큰에 대하여 계산한 어휘집 내의 개별 토큰의 등장 확률을 살피는 것이다. 이때 실제 정답을 기준으로, LLM의 어휘집 내의 모든 어휘에 대하여 매긴 각 확률 중 정답 토큰에 매겨진 확률을 바라보면, 정확히 likelihood인 것이다. 그럴듯함. 얼마나 LLM이 정답을 자연스럽게 여겼는지인 것! (LLM은 토큰단위로 어휘집을 갖고 있고, 항상 매 토큰 입력마다 다음 토큰이 무엇일지에 대한 모든 개별 어휘의 확률을 계산하고 있다.)
앞서 제시한 1행의 예시에서, [metadata frame + 질문]의 직후의 채점 과정을 Github의 프롬프트 형식을 따라 만든 코드로 살피면 다음과 같다. (Qwen2.5-0.5B, 어휘집 어휘 수 151,936개)
정답 문장: "126 wine gallons" => 토큰화
실제 답 토큰: '1' '2' 6' ' wine' ' gallons'
- 선택지 1: "126 wine gallons"
- '다음 토큰': 모델이 준 확률 / 어휘집 내 순위
- '1': 0.326 / 1
- '2': 0.137 / 1
- '6': 0.014 / 18
- 선택지 2: "Burgundy"
- ' Burg': 0.000052 / 559
- 'undy': 0.863 / 1
- 선택지 3: "insufficient information"
- ' insufficient': 0.0000082 / 2099
- ' information': 0.998 / 1
어떤가? 이해가 쏙쏙 되지 않는가? 아주 흥미로운 방식의 평가다.
2.6.2. Free generation
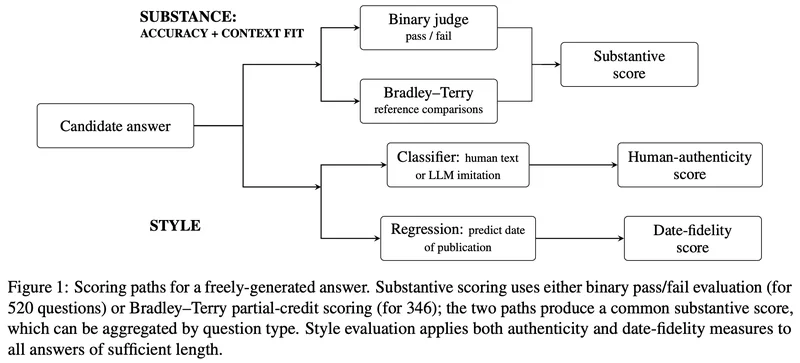
위 그림은 Free generation 갈래의 평가 도식이다.
앞서 Likelyhood 평가에서는 LLM이 실제 답변을 생성하지 않았으나, Free generation에서는 모두 실제 답변을 생성하는 방식의 평가를 진행한다. 첫째는 문체, 둘째는 내용 측면의 평가이다.
이 부분은 논문에 자세히 설명되어 있으므로, 간략히 요약하자면 다음과 같다.
- 문체 판단의 경우:
- DeBERTa 분류기를 학습시켜서, 문장의 연도를 추정하도록 함. + DeBERTa 분류기를 하나 더 학습시켜서, 그 시대 사람이 쓴 글인지 LLM이 모방한 글인지 분류하도록 함.
- 두 분류기가 각각 0-100사이 점수를 매긴다. (연도추정은 예측연도-목표연도의 잔차를 충실도 점수로 변환, 인간 진정성 판별은 진짜 그 시대 글일 확률을 점수로 변환.)
- 진짜 그 시대 글 수준을 100, 완전히 구별되는 수준을 0으로 잡고, 두 분류기 점수를 하나의 점수로 변환한다... (p.13 식(1) 참고)
- 내용 판단의 경우:
-
- 이진판정: Claude Sonnet 4.6으로, "LLM이 출력한 후보 답"과 "정답이라고 밝히지 않은 정답"을 비교하여, 정답보다 낫거나 같다고 판단하면 통과.
-
- 부분점수: Claude Sonnet 5로 다음 세 단계 수행.
- a. 정답과 오답을 비교하여 각 답의 강도를 Bradley-Terry모델로 정하고 이를 기준점으로 고정. (Bradley-Terry model: 승/패 결과를 통해, 실제 실력차에 의한 승/패 기록을 가장 잘 설명하는 변수를 학습시키는 모델. 기준점: 문항마다 미리 준비한 정답-오답 쌍 집합. 평가할 모델의 답이 이 기준점과 비교됨.)
- b. LLM이 만든 모든 후보 답을 기준 집합과 비교해, 후보 답들이 정답들의 평균 강도에서 얼마나 떨어졌는지 잰다.
- c. 위에서 구한 거리를 0-1 점수로 바꾼다. (평균적인 정답이 0.9정도 되게끔 설정)
- 부분점수: Claude Sonnet 5로 다음 세 단계 수행.
-
2.7. 결과
앞서 설명한 벤치마크를 통해 얻은 결과들은 다음과 같이 정리될 수 있어 보인다.
2.7.1. Likelihood + Open weight models
- 시대 텍스트를 조금(1460만 토큰)만 학습시켜도 현대 모델(논문 예시는 Qwen 7B)의 성능이 크게 향상된다.
- 1930년대 이전의 텍스트로만 학습한 Talkie-1930 13B 모델의 성능이 압도적이었다.
- 현대 모델(LLM)은 체계적으로 오답을 고르며(문체가 확률을 좌우하는게 너무 강하며, 현대 LLM이 만든 오답을 고르기를 더 선호한다. 그 문장이 더 자연스러워 보이므로), 무작위보다 못하기도 했다(Qwen 7B).
2.7.2. Free generation + All LLMs
- 내용 측면: 추론(thinknig) 기능이 있는 모델의 성능이 압도적이었다. (이유는 모름)
- 문체 측면: 프런티어 모델들은 시대 문체를 잘 맞추지만, 인간 진정성(인간이 쓴 글인지)은 거의 맞추지 못한다.
2.7.3. 논의와 부수적 발견
- metadata frame은 실제로 효과가 있다. (엉뚱한 것으로 바꾼 경우 모델의 점수 하락)
- 모델이 발전함에 따라 점수가 빠르게 오르고 있다. (GPT-4o 26 - GPT-4.1 44 - GPT-5.6 72)
- 모델은 자기가 스스로 생성한 오답을 비교적 더 잘 알아본다.
- Likelihood 채점 방식은, 확률로 시대 언어를 탐색하는 도구로서 기능할 수 있다. (예를 들면, 1910년대 문장을 두고, metadata frame만 바꿔가며 그 문장이 시기/국적/장르에 따라 얼마나 그럴듯해지는지를 모델에게 확률로 물어볼 수 있는 것.)
- 빈칸채우기의 점수는 이미 좋다. 그러나 Free generation에 대해서는 성능이 아직 멀었다.
- "그럴듯한 역사 챗봇"은, 현대 지식을 마스킹 해 순진함을 지키는 것 보다, 자기 성찰을 키우는 방식을 통해 만들어질 것이라 전망한다. (오염되지 않은 과거 데이터를 재구성하는 것이 아니라, 다른 세계가 만나 그 차이를 성찰하는 데서 역사적 이해가 온다는 관점 설파. (Gadamer, 2004))
참고문헌
- Bradley, R. A., & Terry, M. E. (1952). Rank analysis of incomplete block designs: I. The method of paired comparisons. Biometrika, 39(3/4), 324–345. https://doi.org/10.2307/2334029
- Gadamer, H.-G. (2004). Truth and method (J. Weinsheimer & D. G. Marshall, Trans.; 2nd rev. ed.). Continuum. (Original work published 1960)
- Historical-AI-Lab. (2026). Chronologic-EN (Commit 12fd7bc) [Computer software and data set]. GitHub. https://github.com/Historical-AI-Lab/Chronologic-EN
- Levine, N., Duvenaud, D., & Radford, A. (2026, April). Introducing talkie: A 13B vintage language model from 1930. talkie. https://talkie-lm.com/introducing-talkie
- Qwen Team. (2024). Qwen2.5-0.5B [Large language model]. Hugging Face. https://huggingface.co/Qwen/Qwen2.5-0.5B
- Underwood, T., Qiu, Z., Griebel, S., Nelson, L. K., Roland, E., Shang, W., & Wilkens, M. (2026). Chronologic: Measuring language models' ability to represent the past (arXiv:2609.23178). arXiv. https://doi.org/10.48550/arXiv.2609.23178
사담
LLM의 다음 토큰 결정 과정을 통해 문장의 그럴듯함(liklihood)을 계측한다는 것은 정말로 신선했다.
가장 좋았던 문장은, p.8의 이 부분이다.
"It seems possible that the first plausible historical chatbots will not be produced by blinding models to ensure naïveté, but by fostering higher levels of self-conscious reflection."
오염되지 않은 과거를 재구성 하는 것은 이제와선 불가능하다. 더 높은 수준의 자기성찰을 통해서 역사적 이해를 달성할 수 있다는 것에 동의한다. 이는 창의성과 창작에 대한 기본 태도를 떠올리게 한다. 새로운 것을 창작하기 위해 눈과 귀를 닫고 폐관수련을 하는 것은 완전히 잘못되었다. 세상에 진정으로 새로운 것이 없기 때문이며, 어떠한 사람도 이미 기존의 것에 오염되어 있다고 볼 수 있다. 그러므로 남은 유일한 선택지는, 새로운 것을 만들기 위해 기존의 것을 더 깊고 넓게 알아가는 것이다.